atomic
15 分钟阅读
•
2298 字
+
1427 词
什么是原子变量
- store :原子写操作。
- load :原子读操作。
-
compare_exchange_strong
:传入**[期望原值]和[设定值]**,
- == 当前值与期望值相等时,修改当前值为设定值 , 返回true ==;
- == 当前值与期望值不等时,将期望值修改为当前值,返回false ==。
- compare_exchange_weak :同上,但允许偶然出乎意料的返回(比如在字段值和期待值一样的时候却返回了false),比strong性能更好些,但需要循环来保证逻辑的正确性。
- exchange :交换2个数值,并保证整个过程是原子的。
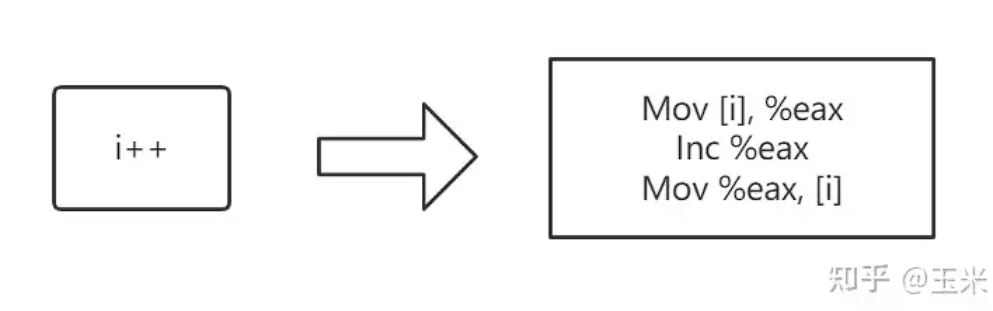
原子操作底层实现
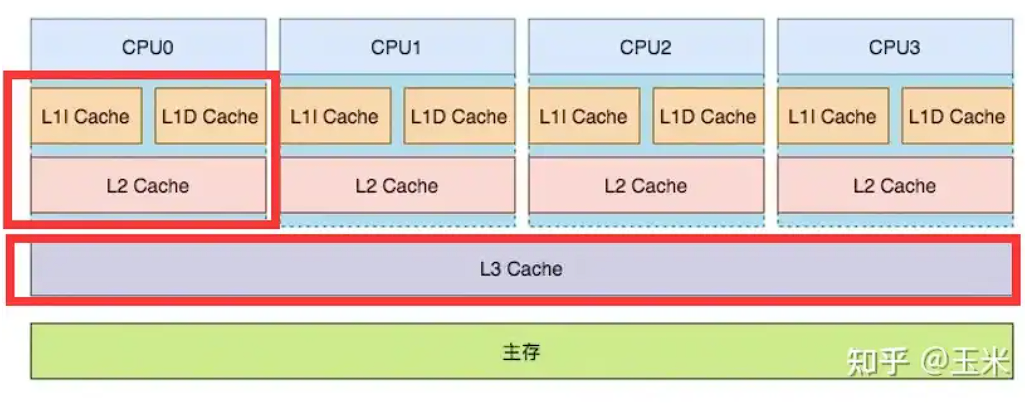
内存序的区分
- 顺序存储 模型(强定序模型)
-
完全存储
定序(TSO)
- x86 CPU 就是这种内存模型,为了提高效率, 其在L1缓存之前加了一个store buffer ,因此写数据指令执行时,会先把更新后的数据放到store buffer里后立刻返回执行下一条指令,store buffer的数据则会慢慢被写到L1 cache中,如果有多条写操作指令,会严格按照FIFO的次序执行。 但无论是否FIFO,总之store buffer的存在已经导致MESI的同步被破坏,写指令立刻返回,后续的指令(比如读操作)可能在store buffer数据还没更新到所有cache和内存之前就执行,这就会出现store-load乱序。
- 部分存储定序(PSO)
- 宽松内存模型(RMO)
内存序就是高层对底层cpu内存模型的一种封装
。
- memory_order_seq_cst: 这是所有atomic操作内存序参数的默认值, 语义上就是要求底层提供顺序一致性模型,不存在任何重排 ,可以解决一切问题,但是效率 最低 。
- memory_order_release/acquire/consume: 提供release、acquire或者consume, release语意的一致性保障 它的语义是:我们允许cpu或者编译器做一定的指令乱序重排,但是由于tso, pso的存在,可能产生的store-load乱序store-store乱序导致问题,那么涉及到多核交互的时候,就需要手动使用release, acquire去避免这样的这个问题了。简单来说就是允许大部分写操作乱序(只要不影响代码正确性的话),对于 乱序影响正确性的那些部分,程序员自己使用对应的内存序代码来控制 。
- memory_order_relaxed: 这种内存序对应的就是RMO,完全放开,让编译器和cpu自由搞,很容易出问题,除非你的代码是那种不论怎么重排都不影响正确性的逻辑,那么选择 这种内存序确实能提升最大性能 。
- memory_order_release
//-将下面代码用release控制
int a = 0;
int b = 0;
void func1(){
    a = 1;
    b = 2;
}

//------------------------------分割线-----------------------------

int a = 0;
std::atomic<int> b(0);
void func1(){
    a = 1;
    b.store(2,std::memory_order_release);//-a的写操作不会重排到b的写操作之后
}
- memory_order_acquire
int a = 0;
int b = 0;
void func1(){
    a = 1;
    b = 2;
}
void func2(){
    while(b != 2);
    cout<<a<<endl;
}

//------------------------------分割线-----------------------------

int a = 0;
std::atomic<int> b(0);
void func1(){
    a = 1;
    b.store(2,std::memory_order_release);//-a的写操作不会重排到b的写操作之后
}
void func2(){
    while(b.load(std::memory_order_acquire) != 2);
    cout<<a<<endl;//-a的读操作不会重排到b的读操作之前
}
c++内存屏障
int a = 0;
int b = 0;
void func1(){
    a = 1;
    std::atomic_thread_fence(std::memory_order_release);
    b = 2;
}
void func2(){
    while(b != 2);
    std::atomic_thread_fence(std::memory_order_acquire);
    cout<<a<<endl;
}
//使用release屏障,相当于写操作a=1不会重排到b之后。
//使用acquire屏障,相当于读操作cout<<a不会重排while(b !=2)之前。
//和刚刚实现了一样的功能。
对于无锁编程的理解
int i;
mutex m;
void func1(){
    lock_guard<mutex> lock(m);
    i++;
}