count()和count(1)区别
10 分钟阅读
•
548 字
+
750 词
COUNT
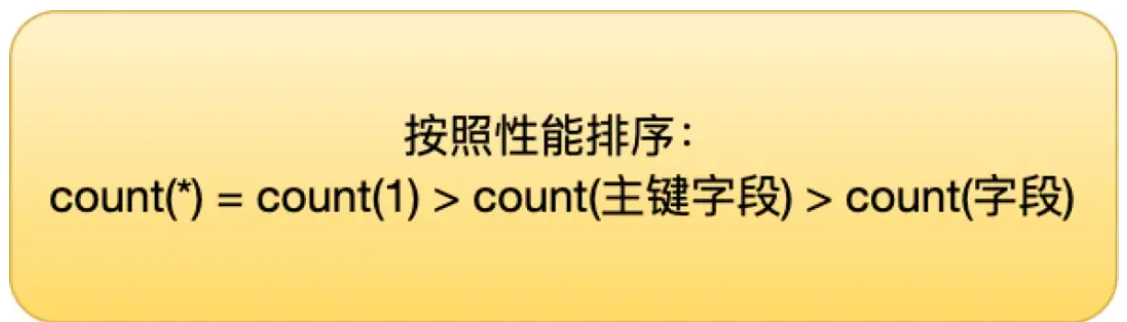
函数用于计算行数,但不同的用法会产生不同的结果。以下是
COUNT(1)
、
COUNT(*)
、
COUNT(主键字段)
和
COUNT(字段)
之间的区别:
1.
COUNT(*)
- 定义 :计算结果集中所有行的总数,包括 NULL 值。
-
特点:
-
不管行中的数据是否为 NULL,
COUNT(*)都会计数。 - 通常是最常用的计数方式,因为它不涉及特定字段的值,速度较快。
-
不管行中的数据是否为 NULL,
2.
COUNT(1)
- 定义 :计算结果集中所有行的总数,其中每一行都被视为 1。
-
特点:
-
与
COUNT(*)类似,COUNT(1)也会计算所有行,包括 NULL 值。 -
实际上,在大多数数据库实现中,
COUNT(1)和COUNT(*)的执行效率是相似的,但其内部实现可能略有不同。
-
与
3.
COUNT(主键字段)
- 定义 :计算结果集中指定主键字段不为 NULL 的行数。
-
特点:
- 只有当主键字段的值不是 NULL 时,才会被计数。
- 如果主键字段是非 NULL 的(因为主键设计的特性),这通常会计数所有行。
-
使用主键字段进行计数可以在一定条件下提高代码的可读性,但在主键总是有值的情况下,可以与
COUNT(*)得到相同的结果。
4.
COUNT(字段)
- 定义 :计算结果集中指定字段不为 NULL 的行数。
-
特点:
- 只有当指定字段的值不是 NULL 时,才会被计数。
- 如果某些行的该字段值为 NULL,这些行将不会被计数。
- 适合用于检查某个特定字段的非空记录数量。