redolog的写入机制
10 分钟阅读
•
727 字
+
744 词
redo log有三种状态
 这三种状态分别是:
存在 redo log buffer
中,物理上是在 MySQL
进程内存
中,就是图中的红色部分;
写到磁盘 (write)
,但是没有
持久化(fsync)
,物理上是在
文件系统的 page cache
里面,也就是图中的黄色部分;
持久化到磁盘
,对应的是 hard disk,也就是图中的绿色部分。
日志写到 redo log buffer 是很快的,wirte 到 page cache 也差不多,但是持久化到磁盘的速度就慢多了。
为了控制 redo log 的写入策略,InnoDB 提供了 innodb_flush_log_at_trx_commit 参数,它有三种可能取值:
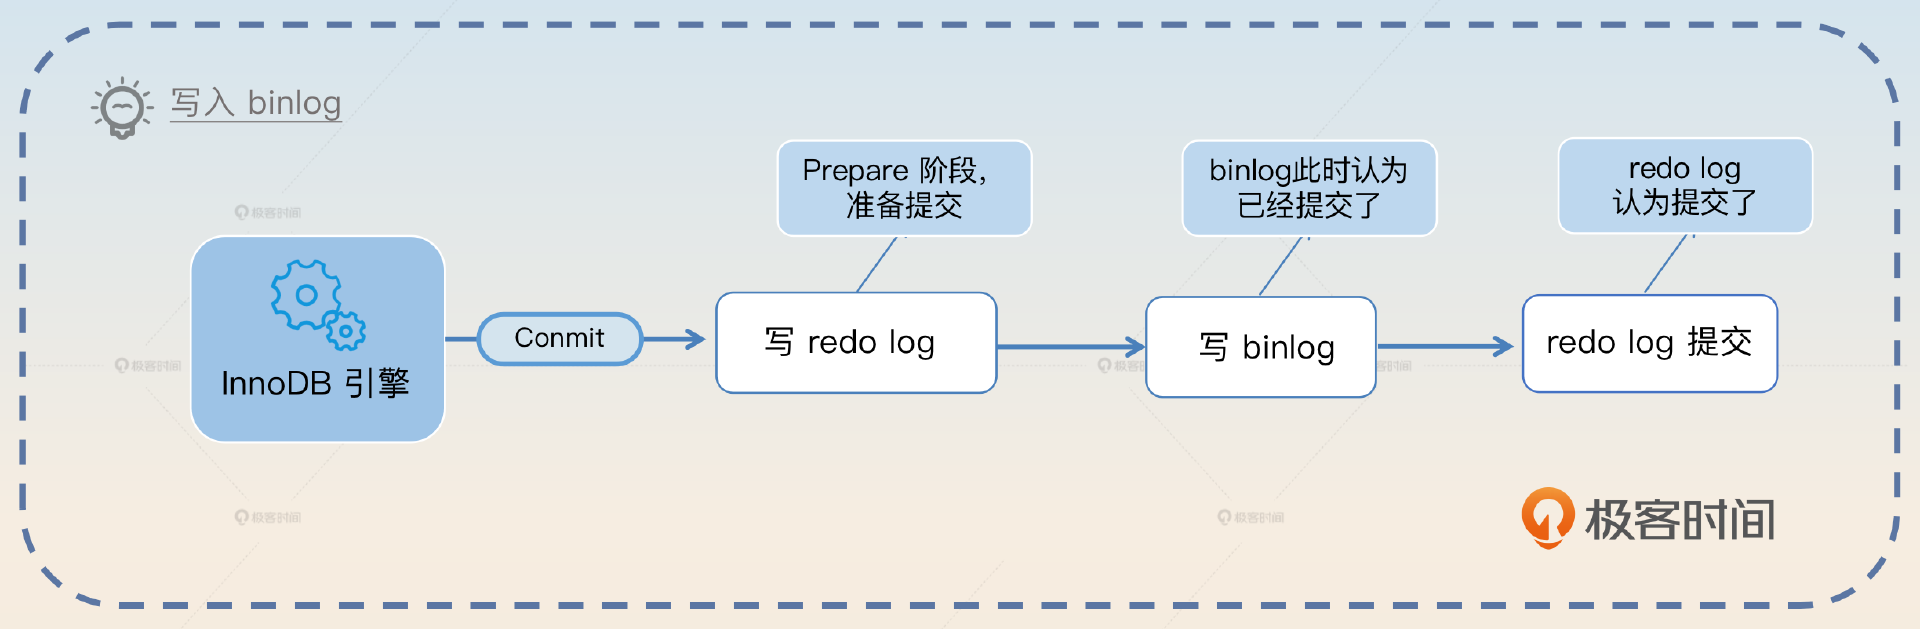 我们介绍两阶段提交的时候说过,
时序上 redo log 先 prepare, 再写 binlog,最后再把 redo log commit。
如果把
innodb_flush_log_at_trx_commit 设置成 1
,那么
redo log 在 prepare 阶段就要持久化一次
,因为有一个崩溃恢复逻辑是要依赖于 prepare 的 redo log,再加上 binlog 来恢复的。
每秒一次后台轮询刷盘,再加上崩溃恢复这个逻辑,InnoDB 就认为 redo log 在 commit 的时候就
不需要 fsync
了,只会 write 到文件系统的 page cache 中就够了。
现在你就能理解了,WAL 机制主要得益于两个方面:
redo log 和 binlog 都是顺序写,磁盘的顺序写比随机写速度要快
;
组提交机制
,可以大幅度降低磁盘的 IOPS 消耗。
- 设置为 0 的时候,表示 每次事务提交时都只是把 redo log 留在 redo log buffer 中 ;
- 设置为 1 的时候,表示 每次事务提交时都将 redo log 直接持久化到磁盘 ;
- 设置为 2 的时候,表示 每次事务提交时都只是把 redo log 写到 page cache 。