索引

20 分钟阅读 1468 字 + 2446 词
四、索引(==重要==)
1、概念
帮助MySQL 高效 获取数据的 数据结构
image-20230630160308180
数据库中的数据存储在磁盘里面。
顺序存储:对 空间的要求比较高 需要连续的大片空间 。查找的时间复杂度O(N),删除插入数据需要移动数据
二分查找(折半查找):也需要连续的空间,对空间的要求比较高。查找的时间复杂度O(logN)
哈希:查找的速度是比较快。但是有哈希冲突。 key值哈希之后是没有顺序的,不能支持范围查找。
二叉树:数据量比较大的时候,树的高度是比较高的。树的高度过高,那么每次比较的时候,都会进行磁盘IO,而磁盘IO的速率是比较慢的,那么树的高度会影响速率。查找的时间复杂度O(logN)
==B树: 每个结点中存放数据key与value值 ,同时还会存放指向孩子结点的 指针 而每个大结点是有大小限制的,那么就会限制一个结点中索引的个数 会导致树的高度更高。 (相对于B+树而言的)。==
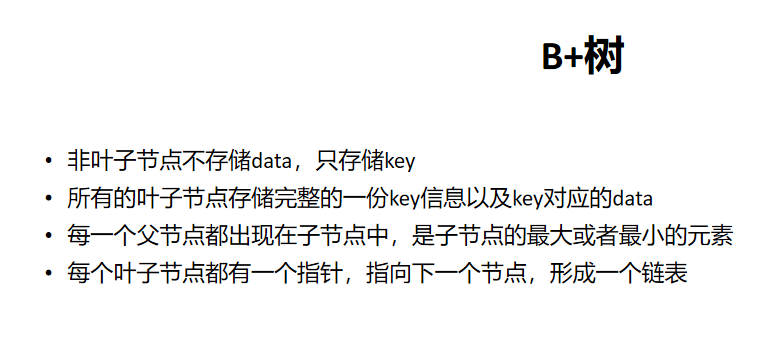
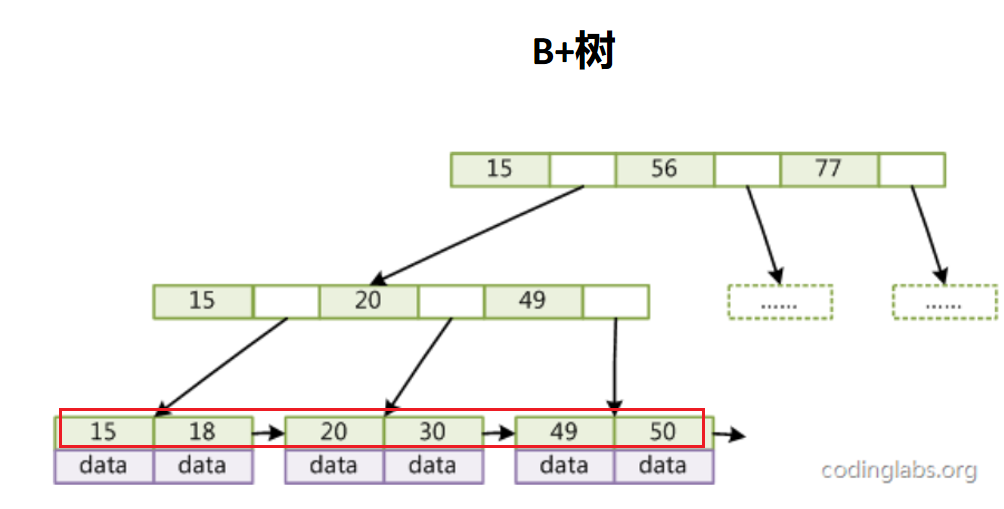
==B+树:每个 非叶子结点只存放数据key信息 不存放value信息 ,这样可以尽量的将 一个结点中索引的条数增加 ,那么就 可以尽量的减少树的高度 ,也就 减少了磁盘IO的次数。 ==
为什么不使用跳表呢?
总结:对空间的连续性、对范围查找、对磁盘IO的次数、查找的时间复杂度。
最终,MySQL数据库中的索引使用的是B+树这样的数据结构。
2、B+树的特征
image-20230630163036005
image-20230630163017013
3、索引的类型
主键索引:以主键创建的索引
非主键索引( 辅助索引 ):以非主键创建的索引。 唯一索引、普通索引、组合索引、全文索引。
4、索引的创建与删除
4.1、创建主键索引
主键:== 非空、唯一。 ==
mysql
#查看索引
show index from member;

#在创建表的时候,创建出主键
create table test1 (id int, age int, math float, primary key(id));

#在表创建出来之后,再去创建主键
alter table test2 add primary key(id);
4.2、创建唯一索引
特点:== 唯一,但是可以为空 ==
mysql
#在创建表的时候,创建出唯一索引
create table test3 (id int, age int, math float, unique math_idx(math));

#在表创建出来之后,再去创建唯一索引
alter table test4 add unique index math_idx(math);
create unique index age_idx on test4(age);
4.3、创建普通索引
mysql
#在创建表的时候,创建出普通索引
create table test3 (id int, age int, math float,  math_idx(math));

#在表创建出来之后,再去创建普通索引
alter table test4 add index math_idx(math);
create index age_idx on test4(age);
4.4、创建组合索引
将几个列合在一起创建索引
mysql
#在创建表的时候,创建出组合索引
create table test3 (id int, age int, math float, math_age_idx(math,age));

#在表创建出来之后,再去创建组合索引
alter table test4 add index math_age_idx(math,age);
create index age_math_idx on test4(age,math);
4.5、索引的删除
mysql
alter table test4 drop index math_idx;
drop index age_idx on test4;
5、最左前缀(==重点==)
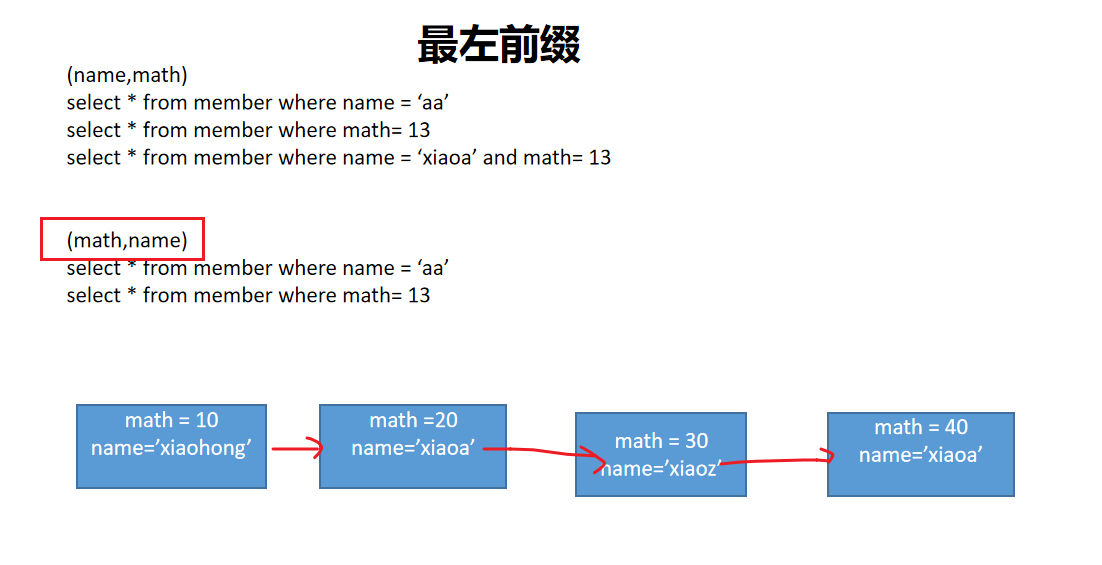
在组合索引中, 哪一列放在前面还是后面,是有区别的 ,r如果以数学成绩与人名建组合索引,比如:**(math,name),那么会先按照math进行排序,然后在数学成绩相同的情况再按照name进行排序,那么单独使用name进行查找的时候,就用不到索引。**但是如果建组合索引的时候,使用(name,math)那么会先按照name进行排序,然后在名字相同的情况再按照math进行排序,那么单独使用math进行查找的时候,就用不到索引。在最左边的列相同的情况,右边的列才局部有序,如果整体来看的话,右边的列是没有顺序的。
image-20230630173545550
6、索引的优缺点
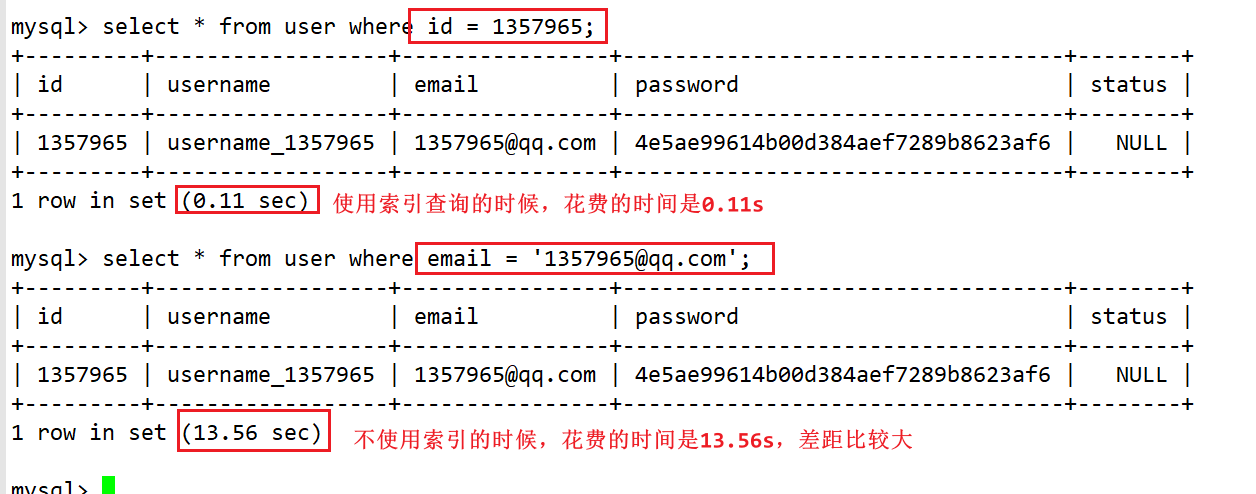
优点:== 提高查询速率,减少IO成本。 ==
缺点: 1、索引也会占用空间。2、更新索引也会耗费时间,会影响表的更新速率
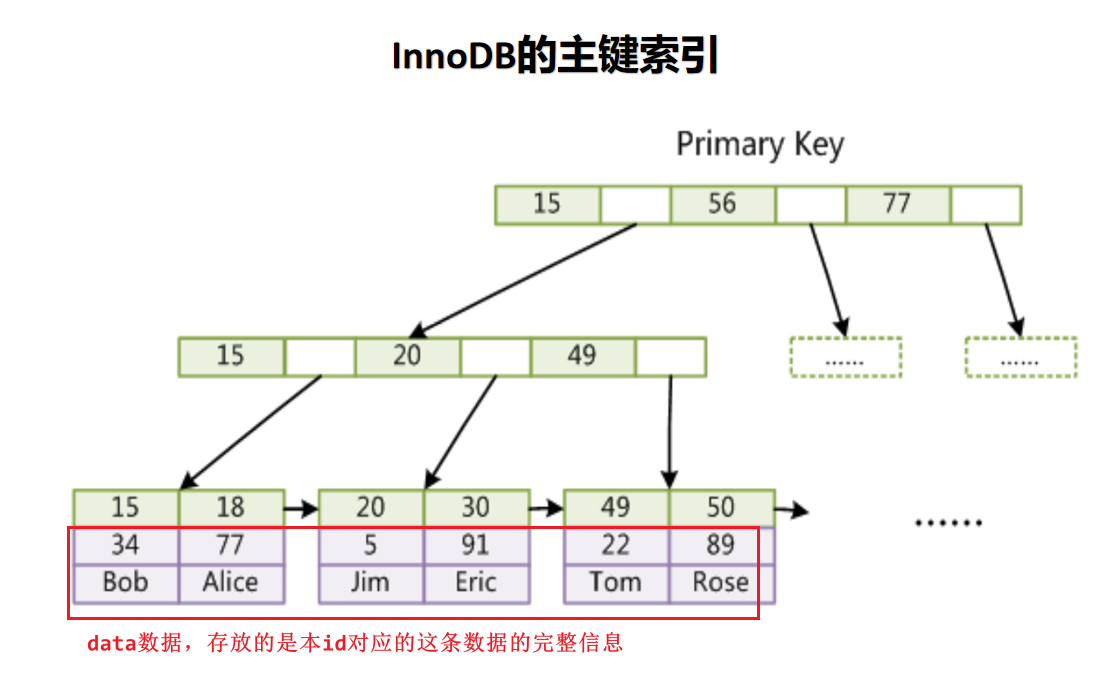
1、InnoDB使用主键创建索引
image-20230703101618738
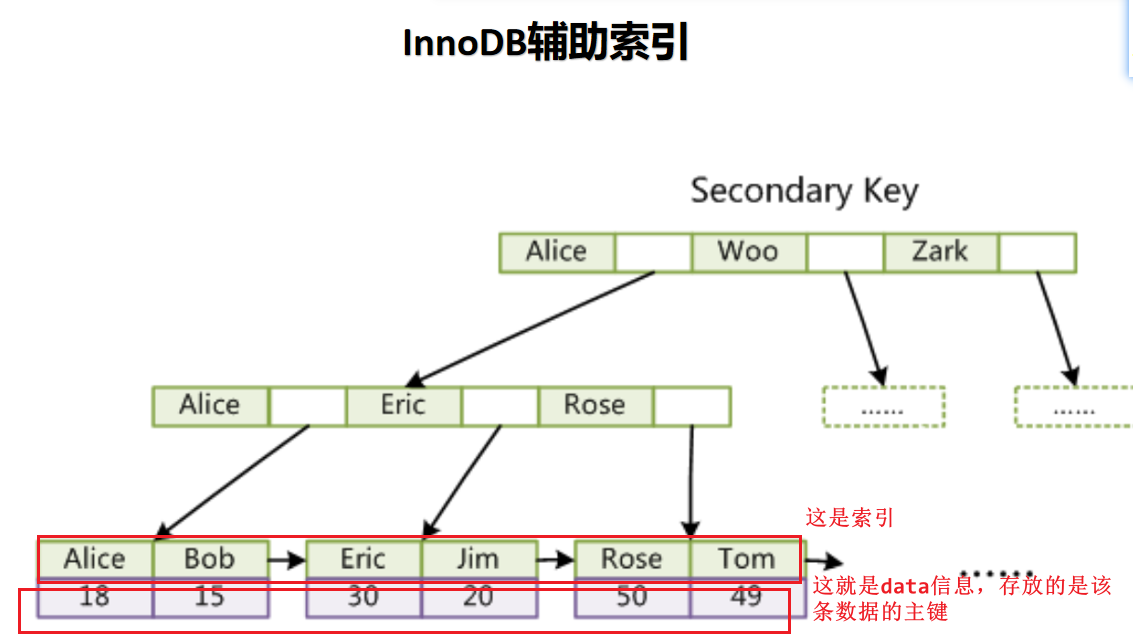
2、InnoDB使用非主键创建索引
image-20230703102128436
如果使用主键进行查询,那么select后面的所有列都可以在主键索引树上查到。但是,如果查询的时候, 查询条件使用的是辅助索引,那么select后面的列,如果使用的是 (星号),那么在辅助索引树的叶子结点下面,有些列是无法查到的,因为叶子结点下面的data信息中存放的是该条数据的主键。如果select后面的列不是主键也不是查询的列(例如此处的age),那么就需要在辅助索引树下面找到主键,然后再通过主键在主键索引树上将待查询的列找到 ,就这种现象称为* 回表 。如果待查询的列在辅助索引树上可以命中的,就称为 索引覆盖(覆盖索引)
mysql
//id = primary key   name = index  
select age from tableName where id = 18;
select age from tableName where name = 'Alice';
select id,name from tableName where name = 'Alice';


#没有索引只能全盘扫描
select id,name from tableName where age = 77;
3、MyISAM使用主键创建索引
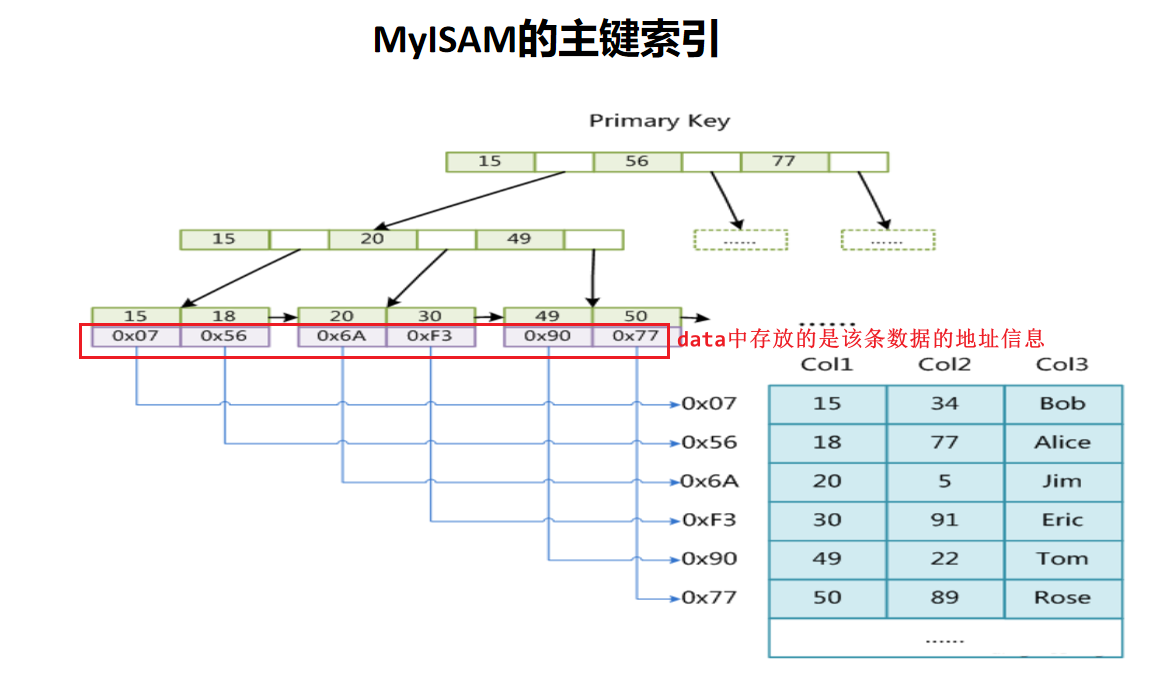
image-20230703110052128
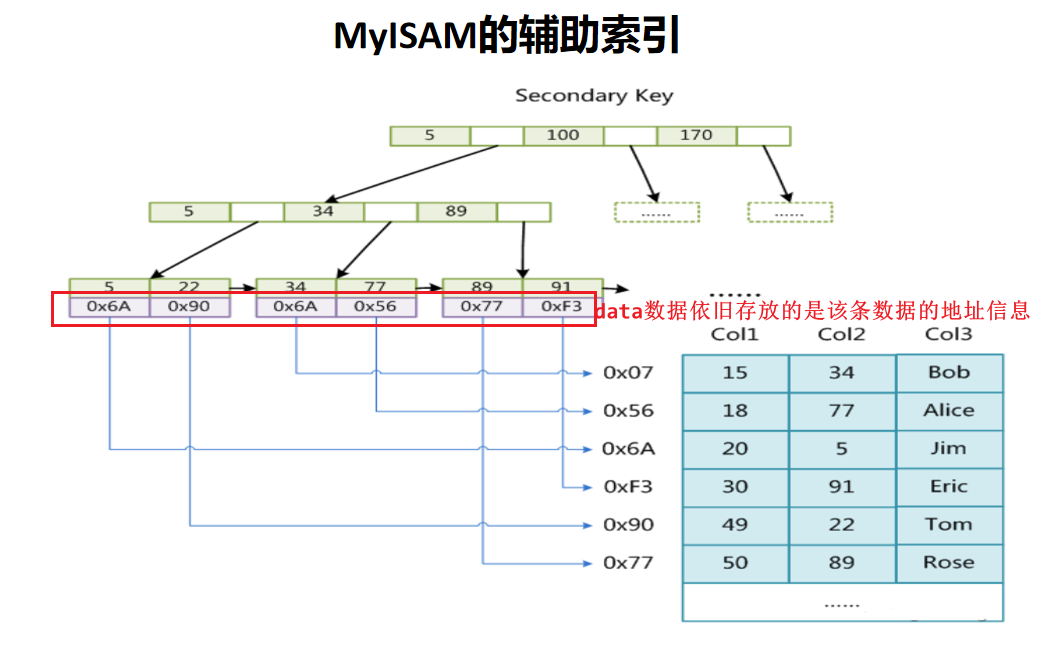
4、MyISAM使用非主键创建索引
image-20230703110159024
额外: 索引下推 (MySQL5.6推出的查询优化策略)
索引下推是虽然 某些列无法使用到联合索引 ,但是它 包含在联合索引中 ,所以可以直接在存储引擎中过滤出来满足条件的记录,如果找到了,就执行回表操作获取整个记录。如果没有索引下推的话 ,找到一个满足第一个条件但是不满足第二个条件的也进行回表将记录传给Server层,然后Server层再进行判断,这样可能会出现多次回表, 因为满足第一个条件的记录可能比较多,每个需要回表一次然后判断一次。
当你的查询语句的执行计划里,出现了 Extra 为 Using index condition ,那么说明使用了索引下推的优化。